Pourquoi les pilotes IA échouent avant la production : méthode de déploiement pour l’entreprise
Par Delos Intelligence — 2026-10-15
Un pilote IA convaincant ne garantit pas un système fiable à grande échelle. Voici comment passer de la démo à une exploitation mesurable, sécurisée et durable.
Un prototype impressionne avec dix exemples choisis. Un système en production doit fonctionner sur des milliers de cas réels, respecter les droits d’accès, rendre ses erreurs visibles et survivre aux changements de données. C’est dans cet écart que de nombreux projets IA d’entreprise s’enlisent. La question n’est pas seulement « le modèle sait-il répondre ? », mais « le processus complet peut-il rendre un service fiable chaque jour ? »
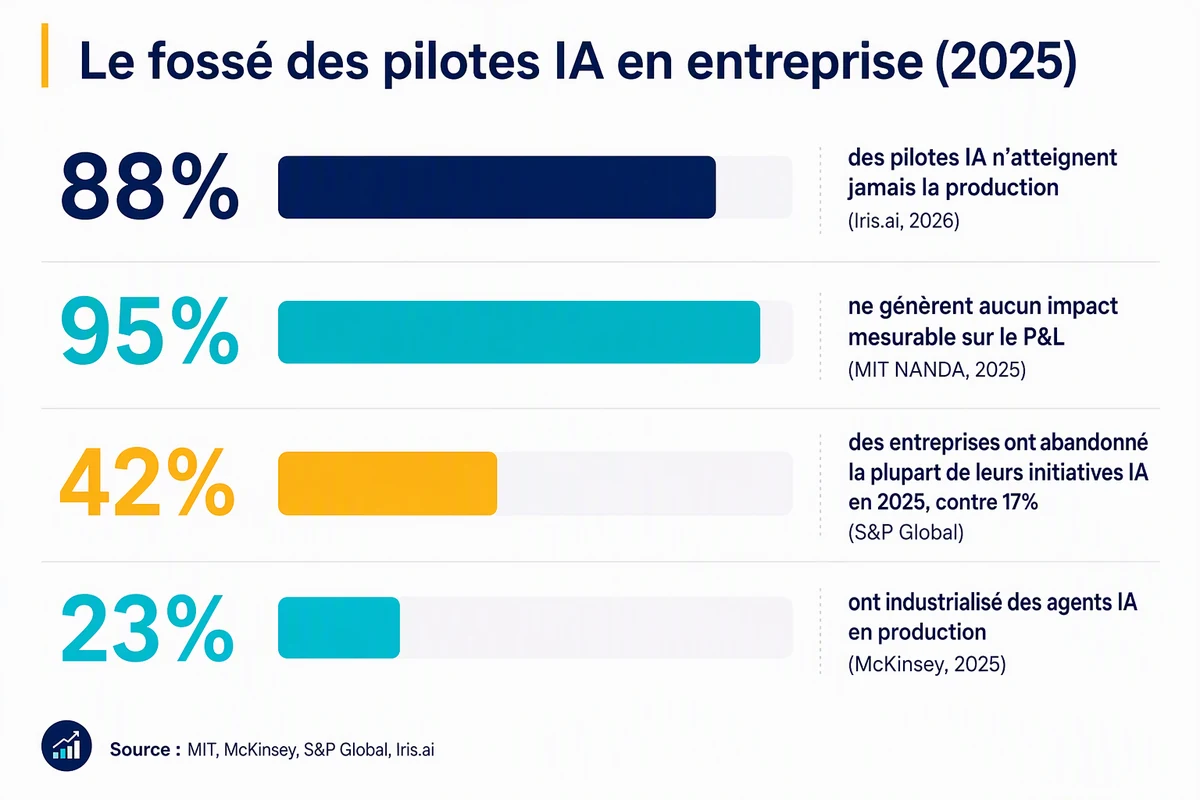
L'écart se mesure. Selon The GenAI Divide: State of AI in Business 2025 du projet MIT NANDA, 95 % des organisations étudiées n'ont observé aucun retour mesurable de l'IA générative sur leur compte de résultat. Cela ne signifie pas que 95 % des modèles ont échoué ni qu'aucun salarié n'en a bénéficié : il s'agit d'un constat sur l'impact économique mesuré. De son côté, S&P Global Market Intelligence indique que la proportion d'entreprises abandonnant la majorité de leurs initiatives IA est passée de 17 % à 42 % d'une année sur l'autre. Ces deux indicateurs mesurent des réalités différentes : ce ne sont pas des taux d'échec interchangeables. Les cinq étapes ci-dessous traduisent ces constats en méthode de mise en production.
!Écart entre un pilote IA isolé et son déploiement à l’échelle de l’entreprise
Pourquoi le pilote fonctionne alors que la production échoue
Une démonstration teste le modèle ; l’exploitation teste le système
En atelier, l’équipe sélectionne des documents propres, corrige discrètement les réponses et ignore les cas hors périmètre. Dans le travail quotidien, arrivent des pièces manquantes, des informations contradictoires, des demandes urgentes et des utilisateurs dont les permissions diffèrent. Un taux de réussite observé sur un petit jeu de tests n’est donc pas une garantie opérationnelle. La revue State of AI de McKinsey examine précisément le passage de l’expérimentation à la création de valeur à grande échelle : gardez le déploiement et la transformation des workflows au centre de l’évaluation, pas uniquement la qualité d’une démo.
Les dépendances restent invisibles jusqu’au raccordement
Une réponse utile dépend d’une donnée à jour, d’un connecteur stable et d’une action autorisée. Identifiez les systèmes sources, les propriétaires de données, les SLA, les règles de conservation et le comportement en cas de panne. Sans cette cartographie, le pilote contourne les étapes que la production ne peut pas contourner. Pour approfondir la couche technique, consultez notre guide des modèles de déploiement des agents IA.
Personne n’est responsable des exceptions
Qui corrige une décision erronée ? Qui arrête l’automatisation lors d’un incident ? Qui valide un changement de modèle ? Si ces réponses restent implicites, le projet prend du retard au premier contrôle de sécurité. Le cadre de gestion des risques IA du NIST propose une façon de structurer la gouvernance, l’identification, la mesure et le traitement des risques. Notre article sur la responsabilité des agents IA complète cette approche du point de vue des rôles métier.
Une méthode pratique pour passer du pilote à la production
!Étapes du passage d’un pilote IA à un service de production mesurable
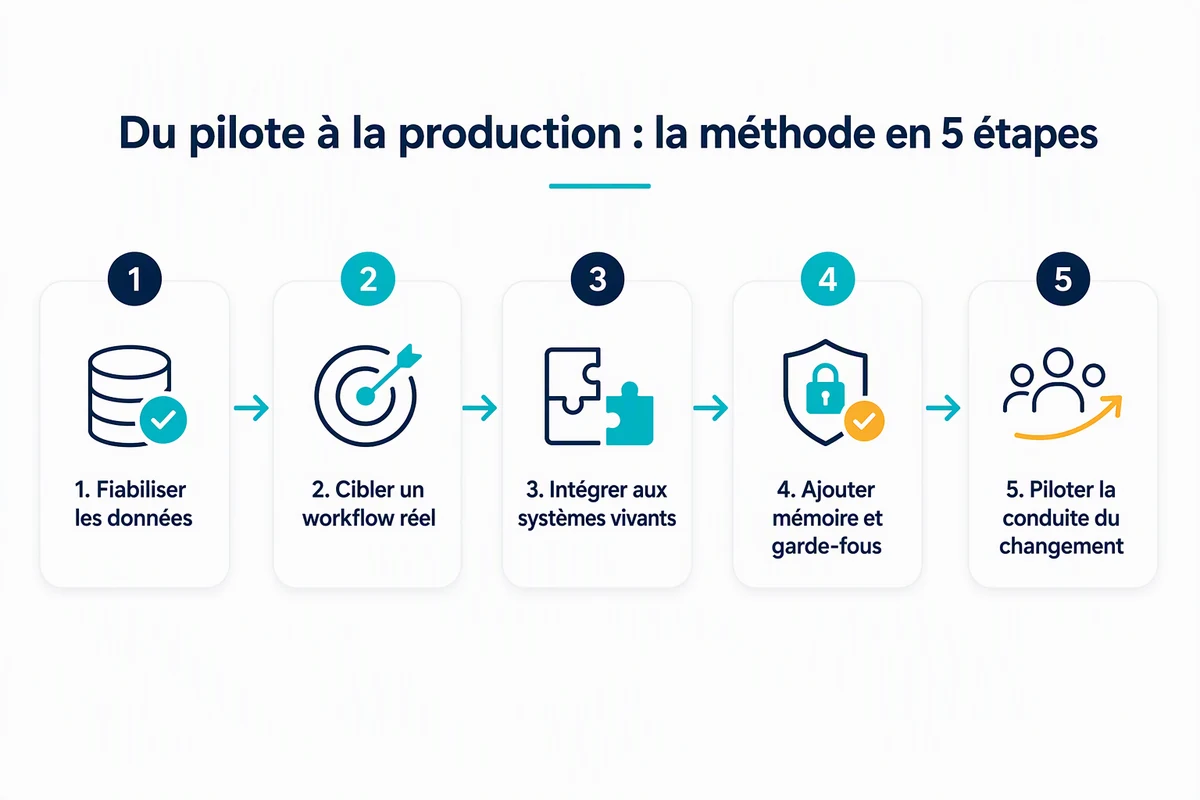
1. Choisir un workflow et définir le résultat attendu
Décrivez une entrée, une sortie et un responsable. Mesurez une ligne de base avant toute automatisation : délai de traitement, taux d’erreur, coût par dossier et satisfaction des utilisateurs. Fixez des seuils d’acceptation et une limite de coût par tâche. Un projet sans métrique avant/après peut prouver qu’il fonctionne, mais pas qu’il apporte de la valeur.
2. Tester les cas difficiles avant d’augmenter le volume
Construisez un jeu d’évaluation à partir de vrais cas autorisés, anonymisés si nécessaire : demandes ambiguës, doublons, informations sensibles, données périmées, échecs de connecteurs et tentatives de contournement. Mesurez séparément les bonnes réponses, les erreurs acceptables, les erreurs graves et les refus pertinents. Refaites ces tests à chaque modification du prompt, du modèle ou de la base documentaire. Pour aller plus loin, voyez notre méthode d’évaluation des agents IA.
3. Encadrer les actions et les accès
Appliquez le principe du moindre privilège. Séparez lecture, proposition et exécution : une réponse rédigée peut être automatique, tandis qu’un paiement, une suppression ou un envoi externe exige une validation humaine. Journalisez les sources consultées, les outils appelés, les décisions et les approbations, sans conserver plus de données personnelles que nécessaire.
4. Lancer progressivement et prévoir le retour arrière
Commencez par un mode observation, puis une cohorte limitée, puis une extension conditionnée aux métriques. Définissez un propriétaire d’astreinte, une procédure de désactivation, un traitement manuel de secours et des critères de suspension. Les pratiques de MLOps et de livraison continue décrites par Google Cloud illustrent pourquoi versions, automatisation et surveillance comptent autant que le modèle initial.
5. Suivre la valeur après la mise en service
Surveillez qualité par catégorie de cas, taux d’escalade, latence, coût, incidents et adoption réelle. Écoutez les équipes qui reçoivent les exceptions : un gain de temps au début du processus peut simplement déplacer le travail vers l’aval. Réévaluez les seuils et retirez les automatisations qui ne tiennent pas leurs promesses.
Voir la vidéo : orchestrer des workflows IA complexes avec des agents et des LLM
La règle de décision avant le lancement
N’ouvrez pas la production parce qu’une démo a convaincu la direction. Ouvrez-la lorsque le workflow a un propriétaire, que ses cas limites ont été testés, que les permissions sont limitées, que les incidents ont une procédure et que l’équipe peut mesurer une amélioration nette. Le bon objectif n’est pas « plus de pilotes » : c’est moins de distance entre une idée prometteuse et un service réellement exploitable.