Architecture de mémoire des agents IA : les 3 niveaux indispensables en production
Par Delos Workers team — 2026-11-01
Votre agent oublie ce que vous lui avez dit la semaine dernière. Une fenêtre de contexte plus grande n'y changera rien. Voici l'architecture qui règle le problème.
Lundi, votre agent a géré un litige fournisseur sans accroc. Jeudi, il repose les mêmes questions. Ce n'est pas un problème de modèle, c'est un problème d'architecture : l'agent n'a pas de mémoire digne de ce nom. En 2026, la mémoire est traitée comme un composant à part entière, à côté de la fenêtre de contexte, et non comme un prompt plus long.
Pourquoi une fenêtre de contexte plus grande n'est pas une mémoire
Le réflexe, face à un agent qui oublie, est d'allonger la fenêtre de contexte. Cela ne marche pas. Le problème n'est pas la capacité de stockage : c'est de décider ce qui mérite d'être gardé, ce qui a cessé d'être vrai et ce qui doit remonter maintenant. Une fenêtre d'un million de jetons contient plus de conversation, mais ne résout pas une préférence exprimée en mars et contredite en juillet. Les praticiens notent aussi que la récupération se dégrade pour une raison contre-intuitive : la recherche est rarement mauvaise, mais d'anciens éléments non pertinents passent devant le contexte récent. C'est un problème de classement, pas d'embeddings (GMI Cloud, Agent Memory Architecture for Production, oct. 2026).
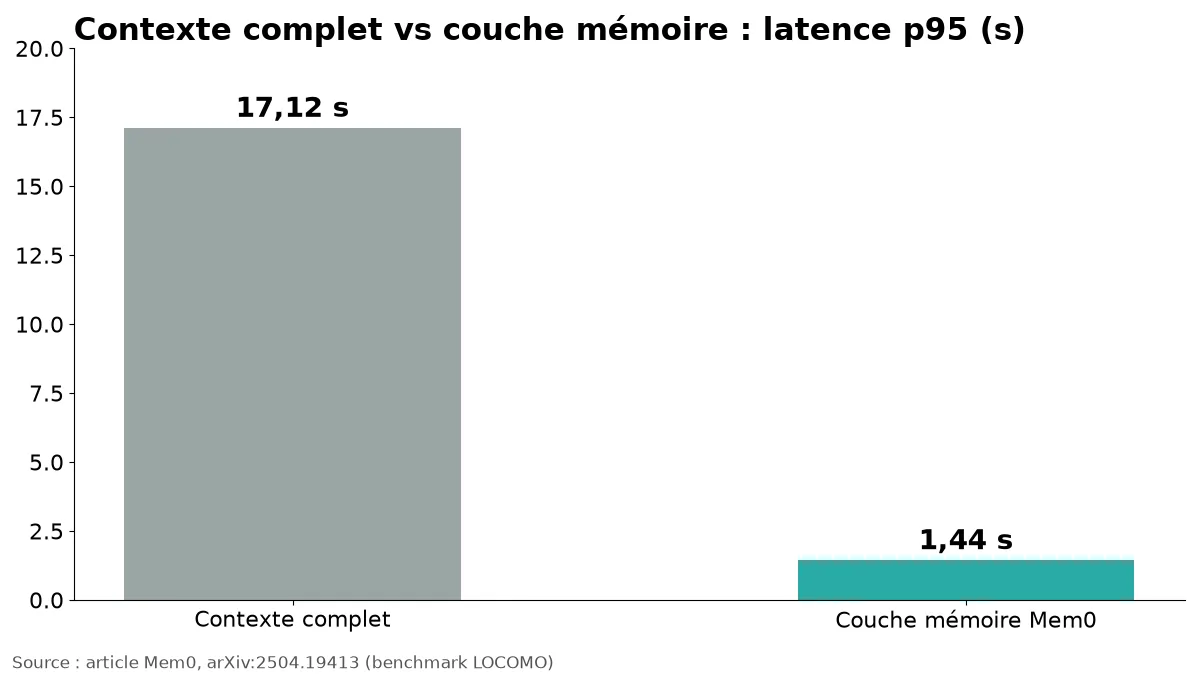
Le coût de l'ignorer est concret. Sur le benchmark LOCOMO, l'équipe Mem0 mesure une latence p95 de 17,1 secondes quand tout l'historique est passé dans le contexte, contre 1,44 seconde avec une couche mémoire dédiée (Mem0, arXiv:2504.19413).
Les trois niveaux de mémoire d'un agent
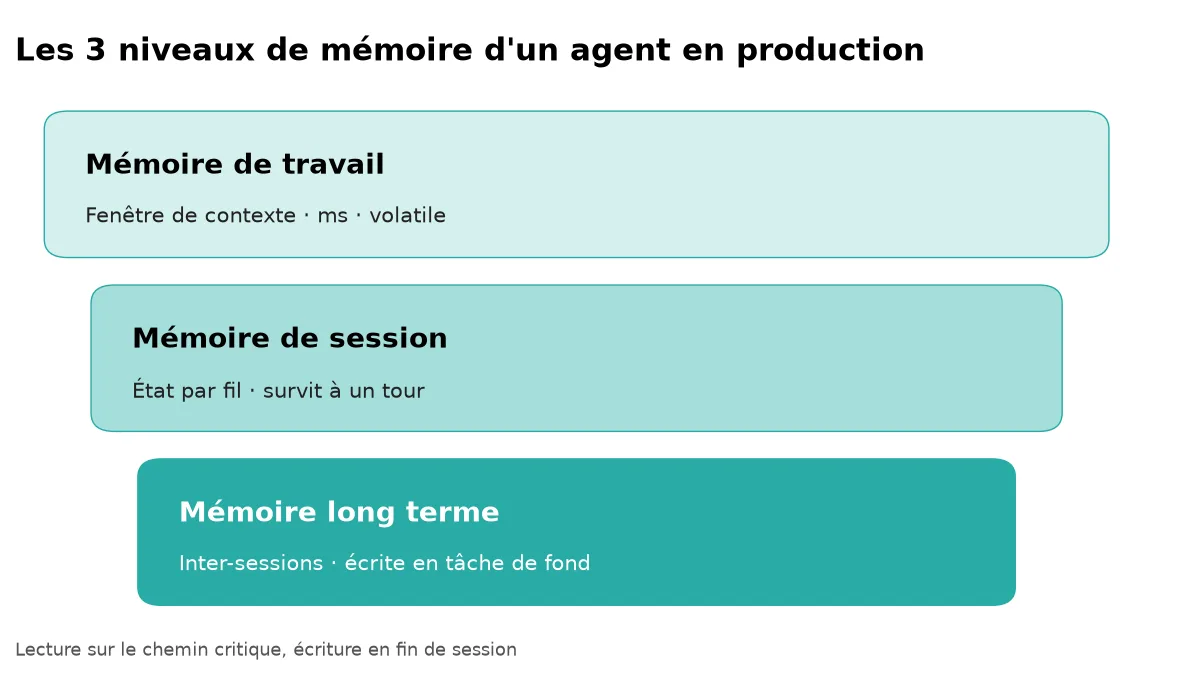
1. La mémoire de travail
C'est la fenêtre de contexte elle-même : les instructions, la tâche en cours et les quelques faits utiles tout de suite. Rapide et volatile. Règle : la garder courte et triée, ne jamais s'en servir comme archive.
2. La mémoire de session
L'état par fil de discussion qui survit à un tour : le ticket traité, les documents déjà ouverts, les décisions prises. Elle permet de reprendre une tâche en plusieurs étapes après une interruption. Règle : la stocker hors du prompt, indexée par fil, et l'expirer à la clôture de la tâche.
3. La mémoire long terme
Les connaissances qui persistent entre les sessions : préférences client, incidents passés, procédures validées. C'est le seul niveau vraiment difficile. Elle se divise en mémoire épisodique (événements datés : « le 12 mars, le client a refusé le devis ») et mémoire dérivée ou sémantique (faits distillés : « ce client négocie les délais de paiement, pas le prix »). La conception MemCurrent de Databricks (oct. 2026) combine précisément ces deux idées : des enregistrements épisodiques bruts et une mémoire dérivée construite à partir d'eux.
Les règles d'écriture : la décision qui fait la différence
Trois règles qui fonctionnent en production :
- Lire sur le chemin critique, écrire en tâche de fond. Un utilisateur qui attend une extraction mémoire attend un travail qui n'améliore pas sa réponse. Écrivez en fin de session.
- Consolider par lots. Le stockage vectoriel coûte peu. Les appels LLM d'extraction et de consolidation peuvent coûter 10 à 100 fois plus que le stockage (GMI Cloud). Consolider par session plutôt que par message est souvent la meilleure décision de coût.
- Gérer contradictions et péremption. Chaque souvenir porte une date et une source. Quand un fait nouveau contredit un ancien, on met à jour ou on retire l'ancien au lieu d'empiler les deux.
Un exemple concret en entreprise
Prenez un agent de relance commerciale (voir notre article sur les relances sans réponse). La mémoire de travail contient l'email en cours de rédaction. La mémoire de session contient l'affaire ouverte et les trois derniers échanges. La mémoire long terme sait que cet acheteur répond le mardi matin, n'aime pas les pièces jointes et s'est vu promettre un plafond de remise lors de la dernière négociation. Sans le niveau 3, chaque email repart de zéro. Avec lui, l'agent se comporte comme un collègue qui se souvient.
Gouvernance : la mémoire, c'est de la donnée
Ce qu'un agent retient relève de données personnelles et métier. Définissez des durées de conservation, laissez les utilisateurs consulter et supprimer ce qui est stocké, et cloisonnez la mémoire par équipe ou par tenant. La recherche sur la mémoire des agents place de plus en plus la sécurité, la confidentialité et la suppression sûre parmi ses sujets centraux (Memory Papers, memorypapers.org).
Checklist avant la mise en production
- Quels faits doivent survivre à une session, et lesquels non ?
- Où vit chaque niveau, et qui peut le lire ?
- Les écritures sont-elles asynchrones et groupées ?
- Comment résout-on les contradictions et retire-t-on les faits périmés ?
- Un utilisateur peut-il consulter et supprimer sa mémoire ?
- Mesurez-vous la qualité de récupération sur vos propres cas, et pas seulement sur des benchmarks publics ?
Conclusion
La mémoire transforme un modèle brillant en collègue fiable. Commencez par les trois niveaux, écrivez en tâche de fond, datez tout et gardez la possibilité de supprimer. Pour aller plus loin, lisez notre guide sur les workflows agentiques en entreprise et notre comparatif agent, RPA ou script.